DawnSentinel

破晓前哨

2026 年 10 月 13 日
今日精选 10 条 栏目 5 个 9 篇含原文全文 每日 08:00 准时更新
AI 前沿3 条
Faithfulness Without Anchors: A Position Paper on the Structural Misalignments of Explainable AI Faithfulness Metrics for Feature Importance
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「arXiv cs.AI」,版权与著作权归原作者/原站点所有。原文链接:https://arxiv.org/abs/2610.12493
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读arXiv新论文指出,当前可解释AI(XAI)的特征重要性保真度评估指标存在结构性偏差。研究认为现有度量方法缺乏可靠锚点,可能误导工程师对模型可信度的判断,呼吁重新审视评估体系。
arXivLabs: experimental projects with community collaborators

arXivLabs is a framework that allows collaborators to develop and share new arXiv features directly on our website.

Both individuals and organizations that work with arXivLabs have embraced and accepted our values of openness, community, excellence, and user data privacy. arXiv is committed to these values and only works with partners that adhere to them.

Have an idea for a project that will add value for arXiv's community? Learn more about arXivLabs.

前往「arXiv cs.AI」阅读原文 →
AI 智能体三周重构 30 万行代码,Code Health 从 5.6 升至 10.0:代码真的变好了吗?
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「InfoQ 中文」,版权与著作权归原作者/原站点所有。原文链接:https://www.infoq.cn/article/Qk7CzmLpDCvfYpAiU6Tf?utm_source=rss&utm_medium=article
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读某项目使用AI智能体在三周内重构30万行代码,Code Health评分从5.6升至10.0。业界关注点在于自动化指标提升是否等同于实际工程质量改善,需警惕评估维度单一化。
[

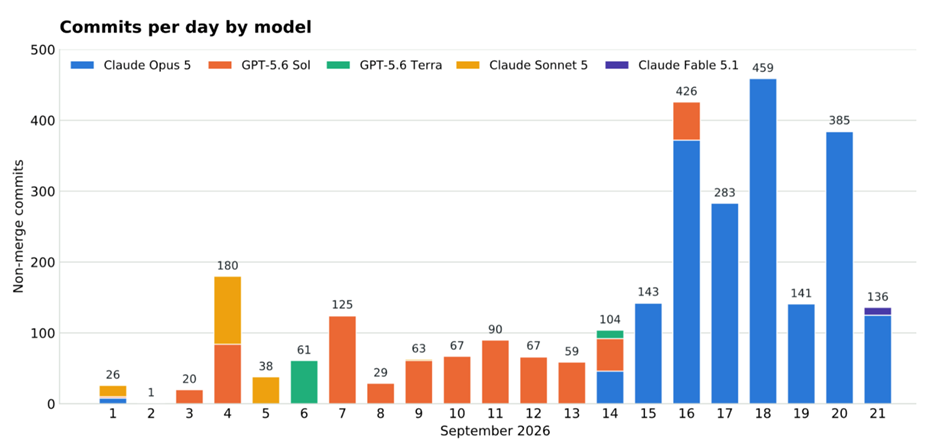
CodeScene 发布了一项案例研究:编码智能体在三周内重构了一个包含 30 万行 C 代码的代码库,token 成本约为 4000 美元。这项工作在 726 个文件中产生了 2903 次提交,修改了 252055 行代码,并将代码库的 Code Health 评分从 5.6 提升至 10.0。该代码库来自《街头霸王 III:三度冲击》的一个开源反编译项目。

CodeScene 创始人、《Your Code as a Crime Scene》作者 Adam Tornhill 写道,在参与大型系统开发 30 年后,这是他第一次看到他所谓的大规模超人类 AI 表现。

两项机制支撑了这项工作。第一项是质量信号:CodeHealth MCP Server 为智能体提供了一个可供优化的确定性评分,并用于判断一次转换是否产生了积极效果。第二项是正确性保障:一个回放轨迹测试框架逐帧比较回滚状态哈希,从而在每次更改后检查系统行为。

更具新意的成果,是智能体在工作过程中构建的内容。它们没有应用固定的重构目录,而是逐步积累了一套重构手册,最终形成 22 个方案和 82 条辅助说明。其中包括 Extract Function 和 Guard Clauses 等常见转换,也包括针对该代码库的特定方案。Shared Index Range 用于处理仅起止范围不同的重复循环;Action Parameter 用于处理主要区别在于所调用函数的重复控制结构;Uniform Step Table 则将异构调用转换为表驱动分派。失败的尝试也被记录下来,包括那些使 Code Health 评分下降的转换。

模型选择也很重要。团队最终决定使用 Claude Opus 完成大部分工作,并报告称,在识别和记录逐渐形成的模式方面,搭配 Opus 的 Claude Code 明显优于搭配 Sol 的 Codex。使用较小模型执行任务时,文件的评分经常停滞,看起来像是到达了一个无法进一步突破的局部最优点。

]
前往「InfoQ 中文」阅读原文 →
何恺明团队发布多模态Harness框架
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「量子位」,版权与著作权归原作者/原站点所有。原文链接:https://www.qbitai.com/2026/10/502628.html
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读何恺明团队发布多模态Harness框架,专为视觉原生多模态模型设计。该框架提供标准化评估与调度接口,旨在降低多模态模型在工程集成中的适配复杂度。
henry16:59:06摘要样式

多模态模型的视觉原生Harness,来了!

henry 发自 凹非寺

量子位 | 公众号 QbitAI

多模态模型的视觉原生Harness,来了!

最近,何恺明团队在最新论文《VISTA: A Visual Harness for Reasoning in an Interactive World》中,提出了一套视觉原生的Harness——

VISTA。

它让现有的多模态模型直接观察环境、保存原始画面,并在推理时随时回看、放大和检查细节,无需从头训练。

相比于传统将环境抽象成文字或代码的做法,VISTA保留了原始的视觉信息。模型可以根据眼下的问题,将过去看过的画面重新调入上下文,参与当前的判断与推理。

基于这套方法,视觉经验成为了模型随时调用、反复检查的上下文,而多模态模型,也有了围绕视觉记忆搭建的原生脚手架。

在评测方面,搭配VISTA,Claude Opus 5.0完成了ARC-AGI-3全部25个公开游戏,相对人类动作效率得分达到满分100,所用游戏动作数比首次游玩的人类基线少57.4%。

换成GPT-5.6 Sol,同样全部通关,得分达到99。

更进一步,团队还在浏览器游戏、迷宫和连线题中验证了这套方法,并将更接近物理世界的具身任务列为后续研究方向。

这是怎么做到的?

视觉原生的脚手架

从ResNet、Mask R-CNN到MAE,视觉感知与表征学习始终是何恺明研究的一条主线。

这一次,VISTA将目光投向了一个新问题:如何让模型在持续交互中积累、保存并利用视觉经验?

答案是Harness。

去年11月,Anthropic曾以长时间编程任务为例,介绍了Harness如何帮助模型跨越多个上下文窗口,持续推进任务。

具体来说,Harness会通过任务清单记录尚未完成的事项,通过进度文件和代码记录保存已经完成的工作。

这样一来,即使模型进入新的上下文窗口,也能通过读取这些信息,了解此前做了什么、接下来该做什么。

复杂任务由此可以分步执行、检查结果,并在不同上下文窗口之间接续工作。

可以说,这套主要通过文字和代码来保存任务状态的Harness,在一定程度上推动了这一波Agent能力的爆发。

然而,在现实环境里,光有文字记忆,显然还不够。

因为一旦进入真实的视觉环境,模型不仅需要记住物体的位置、朝向,还要理解每次动作前后,环境究竟发生了哪些变化。

而且模型第一次看到一张图时,未必知道哪个细节会在后面变得重要。

与此同时,这些视觉信息,也很难提前用一份文字笔记完整记录下来,更难保证模型后续执行任务时,记录的信息依然够用。

在ARC-AGI-3这样的基准中,一种已有思路是先把画面转换成由数字组成的文本网格,再让模型编写程序,模拟环境规则、验证行动方案。

(注释:ARC-AGI-3是一套交互式视觉推理基准,不预先提供游戏规则和目标,智能体需要通过观察和行动,自行摸索如何通关)

但问题在于,环境越复杂,物体的外观、空间关系和动态变化就越难被完整地转化成文字和代码。而且随着交互历史越来越长,早期画面也会被逐渐移出上下文,或者被文字摘要替代。

于是,在这里,VISTA的研究问题就变成了:

如何在不额外训练基础模型的情况下,让智能体在推理需要时,重新检查过去看到的视觉信息?

基于此,VISTA把环境返回的每一帧原样存到上下文之外,包括动作过程中的动画中间帧,模型需要时再取回来。

在ARC-AGI-3评测中,它既能比较不同时刻的画面,也能放大局部,检查小方块上的朝向标记。

其中,文字笔记记录模型当前的理解,原始画面保留供它重新判断的证据。

研究将这种机制称为对交互历史的显式注意力,模型根据正在思考的问题,选择哪些视觉信息重新进入上下文。

要想让这种选择成为可能,系统就得保存原始画面,并提供随时调取和检查的工具。

具体实现

为了让模型能够保存并利用过去的视觉经验,VISTA设计了三个核心组件:

视觉观测、无损视觉记忆和主动视觉检查。这三个组件各有分工,分别负责让模型看清画面、保存历史,以及按需回看。

首先是视觉观测,负责将环境画面提供给模型。

在ARC-AGI-3实验中,VISTA会将官方提供的64×64画面放大为512×512的PNG图像,同时保留物体的颜色、外观和空间关系,让模型能够直接观察环境。

其次是无损视觉记忆,负责保存模型看到的画面。

每次执行动作后,VISTA都会完整保存环境返回的所有画面,包括动作过程中的动画中间帧,并按照回合号和帧号建立索引。

这样一来,模型就不必提前判断哪些信息值得记住,而是可以先把视觉经验完整保存下来,留待后续使用。

最后是主动视觉检查,负责让模型按需回看历史画面。

通过inspect工具,模型可以指定某个历史回合,调出对应画面,也可以裁剪、放大局部区域,检查其中的细节。

如果想知道某次操作究竟改变了什么,模型还可以一次调出多帧画面,对比动作前后的变化。

整个过程相当于给模型配了一套可以随时翻阅的视觉档案。 它不仅能看到眼前的环境,还能主动回看过去的观察结果,为接下来的行动提供依据。

说到这,这三个组件具体是如何配合工作的?

按照VISTA的执行流程,每个回合开始时,模型会先观察当前画面和可用动作,再结合此前积累的经验,判断当前环境的状态,并提出下一步行动的假设。

如果现有信息不足,模型就可以调用工具,回看历史画面、放大局部区域,甚至读取具体的像素信息,进一步寻找证据。

找到证据之后,模型并不会直接行动,而是先预测这次操作可能带来什么变化。

等动作执行完毕,再将实际结果与预测进行对比,检查自己的判断是否正确,并据此修正对游戏规则的理解。

如此反复,模型就能在持续交互中,一边探索环境,一边积累经验。

当然,光有视觉档案还不够。为了让模型在长时间任务中保持连贯,VISTA还引入了两份文字笔记:

  • GUIDE.md:记录不同关卡之间可以复用的规则和经验。
  • WORKING.md:记录当前关卡的状态、进度和后续计划。

当上下文接近上限时,模型会先整理交接摘要,再进入新的上下文窗口继续执行任务。此前的文字笔记、动作历史和视觉档案都会保留下来。

这里还有一个值得注意的设计:VISTA虽然完整保存了历史画面,却不会把所有图片一股脑塞进模型的上下文。

在完整方案中,每次执行动作后,框架默认只向模型展示最后一帧。至于动作过程中的中间画面,则统一保存在视觉档案里,等模型需要时再主动调取。

这样既保留了完整的视觉信息,也避免大量历史图片持续占用上下文空间。

更重要的是,VISTA并没有为此额外训练一个新模型。

环境理解、行动规划和推理仍然由现成的多模态模型完成,Harness则负责执行工具调用、保存视觉历史,并在模型需要时提供相应的证据。

换句话说,VISTA改变的不是模型本身,而是模型获取、保存和使用视觉信息的方式。

实验验证

除了开头提到的实验以外,团队还在GameWorld、AI GameStore和BabyVision三个基准上测试了VISTA,覆盖浏览器游戏、迷宫和连线等任务。

使用相同的GPT-5.6 Sol模型,相比官方基础框架,VISTA在GameWorld的170项任务中,将成功率从40.0%提高到63.3%;

在AI GameStore的10个游戏中,综合得分从47.3升至140.3,其中人类中位数被归一化为100;

在BabyVision选取的39道迷宫与连线题上,准确率从41.0%提高到63.2%。最后这组任务只有静态图片,模型也能通过放大局部、检查像素,改善判断。

这些结果表明,保存原始画面、让模型按需回看,可以进一步发挥现有多模态模型的能力。

同一套VISTA框架只需少量适配,就能用于不同的游戏与谜题,也展现了它在更多视觉任务中的应用潜力。

在结论上,研究将未来的验证方向指向更接近物理世界的具身任务:让模型在持续变化的环境中,保存、复查并利用自己的视觉经验,决定下一步行动。

最后,让我们介绍这篇工作的作者们。

论文的三位共同第一作者为Qiushi Han、胡珂雅和Linlu Qiu,另外两位作者为Cathy Wu和何恺明。

Qiushi Han(Josh Han)目前是MIT运筹研究中心博士生,导师为Cathy Wu。

胡珂雅(Keya Hu)目前是MIT电气工程与计算机科学系博士生,由何恺明和Jacob Andreas联合指导。

她本科毕业于上海交通大学ACM班,研究兴趣集中在语言与视觉的交叉领域,希望构建数据效率更高、泛化能力更强的智能体。

Linlu Qiu目前是MIT电气工程与计算机科学系及计算机科学与人工智能实验室的博士生,导师为Yoon Kim和Jacob Andreas。

其研究方向包括自然语言处理和机器学习,曾在Google Research及Meta FAIR开展研究。

Cathy Wu目前是MIT土木与环境工程系、数据系统与社会研究所副教授,研究如何用机器学习和强化学习改进交通等复杂系统。

她在MIT获得学士和工程硕士学位,随后在加州大学伯克利分校获得博士学位。

何恺明目前是MIT电气工程与计算机科学系终身副教授,也是ResNet、Mask R-CNN和MAE等工作的主要作者。

他本科毕业于清华大学、博士毕业于香港中文大学,曾任职微软亚洲研究院和FAIR,于2024年加入MIT。

参考链接
[1]https://arxiv.org/pdf/2610.02200

版权声明版权所有,未经授权不得以任何形式转载及使用,违者必究。
前往「量子位」阅读原文 →
网络安全与攻防2 条
7分钟加密3.6PB,运维7小时没找到勒索信:日本国家级云平台被黑全过程
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「安全客」,版权与著作权归原作者/原站点所有。原文链接:https://www.anquanke.com/post/id/316231
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读日本某国家级云平台遭勒索软件攻击,攻击者7分钟内加密3.6PB数据,运维团队耗时7小时未发现勒索信。事件暴露出大规模云环境在异常行为监控与应急响应上的严重滞后。

阅读量29223

x
译文声明

本文是翻译文章

译文仅供参考,具体内容表达以及含义原文为准。

软银旗下IDCF Cloud遭勒索攻击,495家客户受影响,黑客公开嘲讽运维应急处置。

10月7日凌晨3点40分,日本软银旗下的云服务商IDC Frontier(IDCF Cloud)东日本第1区域突发大面积故障。众多客户发现自己的虚拟机无法启动,控制台密码被重置,工单像雪片一样涌进来。而彼时,机房里的运维人员还在做一件事——反复重启那些根本不可能再启动的服务器。

直到客户比他们更早发现问题,直到黑客把嘲讽信息直接打在了云管理控制台的首页上,这场持续7小时的事故才被”确认”。这不是一场零日漏洞攻防战,而是一次教科书级别的安全应急响应失败。更值得所有做云、做运维、做安全的人警醒:当攻击者已经在你家里待了7小时,而你连门都没发现被撬开,问题就不只是技术了。

一、事故回放:一场7分钟与7小时的荒诞对照

根据日本ITmedia NEWS报道和安全内参整理,这起事件的经过堪称离奇。

攻击者声称,仅用7分钟就完成了对东日本第1区域全部数据的加密。涉及的数据量令人瞠目:239台虚拟化宿主机、225个数据存储区、至少1.66万块虚拟机磁盘无法使用,被加密的主存储数据达3.6PB,被摧毁的554153份快照,造成的备份容量损失高达41.5PB。

而之后的7个小时,IDC Frontier的运维团队始终没有发现异常。攻击者早在凌晨3点就已在225个数据存储区的根目录中留下了勒索信,文件名为RECOVER-INFO.txt。但运维人员没有找到任何一封,反而不断通过VMware vCenter尝试重启那些已经无法运行的虚拟机,并一遍遍修改管理控制台密码。

客户比运维更早发现问题。日本时间早上8点34分之前,第75号工单就已经报告”虚拟机无法启动”。攻击者显然被这种处置能力”整破防”了,最终直接篡改了云管理控制台,用黑底红字主页面对外宣告:”IDCF CLOUD INFRASTRUCTURE SEIZED(IDCF云基础设施已被我们接管)”,副标题是”YOUR CLOUD IS OURS(你们的云,现在归我们了)”。

攻击者甚至贴心地给出了排查指引:任选一台JE0集群ESXi宿主机,打开SSH或DCUI shell,执行命令查看RECOVER-INFO.txt。言下之意——我们留了225份通知,你们居然一份都没看到。

二、技术拆解:这不是攻防战,是应急响应失能

抛开戏剧性,这起事件有几个技术点值得同行反复咀嚼。

第一,加密速度与破坏规模严重不对等。7分钟加密3.6PB数据,说明攻击者在此之前已经完成了权限获取、横向移动、宿主机控制等前置动作,最后一波加密只是”按下按钮”。真正的入侵窗口远早于10月7日,只是到这天凌晨才引爆。这再次印证了一个残酷事实:勒索软件只是”最后一公里”,前面的潜伏期可能长达数周甚至数月。

第二,备份被同时摧毁。攻击者不仅加密了主存储,还销毁了55万份快照、抹除了41.5PB备份。这在勒索攻击中是最致命的一环——没有离线、不可变备份,受害者就彻底失去了议价能力。IDC Frontier在10月8日的公告中承认,受影响区域存储的客户数据预计难以提取或恢复,只能让客户依靠自己的独立备份在别处重建业务。翻译过来就是:服务商这边的数据,救不回来了。

第三,应急响应的”失明”。反复重启已死掉的虚拟机、反复重置控制台密码,这些操作说明运维团队从未建立起有效的告警—研判—拉群通报链路。勒索信落在宿主机根目录,7小时无人发现,本质是资产清点不清、日志监测缺位、应急SOP形同虚设三重问题的叠加。

三、影响评估:495家客户的”数据孤儿”困境

据IDC Frontier官方公告,此次故障影响东日本第1区域的tesla、henry、pascal、joule四个可用区,当时一对一通知的受影响客户达495家,其中包含企业及地方政府机构。

对云服务客户而言,这起事件暴露了”上云即安全”的认知误区。当你把业务托付给云服务商,你实际上是把数据的可用性、完整性、机密性都托付了出去。一旦服务商遭遇”灭顶式”攻击,客户几乎没有自救空间——除非你自己在异地、离线保留了独立备份。

值得注意的是,IDC Frontier没有支付赎金,而是选择持续对外发布事故进展公告、同步调查情况。这个处置方向是对的,但代价是客户数据的实际损失已经发生。

四、应对措施:运维和安全团队今天就能做的几件事

从这起事件里,我们可以提取出几条可落地的建议。

一是把备份从”在线”变成”离线+不可变”。3-2-1备份原则(3份数据、2种介质、1份异地)是老生常谈,但真正做到”物理隔离、不可篡改”的团队并不多。建议对核心数据实施WORM(一次写入多次读取)存储或直接离线冷备,让攻击者即使拿到宿主机权限也无法一键删除。

二是虚拟化平台的加固必须单独立项。VMware vCenter、ESXi宿主机是勒索攻击的高价值目标。要限制vCenter的外网暴露,启用强认证,对宿主机SSH/DCUI访问做源头管控和白名单,并监测异常的批量磁盘加密行为。

三是建立”不可忽视”的告警通道。攻击者这次是靠篡改控制台才让运维”看见”,说明常规告警完全失效。建议对关键存储根目录、宿主机文件变动、批量虚拟机异常宕机等设置高优先级告警,并直接推送到值班人员手机。

四是定期做无预告的勒索应急演练。这次事故最扎心的地方在于——真出事时,团队连”我们被勒索了”都判断不出来。只有反复演练,才能在真实的7小时里做出正确动作,而不是当7小时的”重启仙人”。

总结

一场7分钟的攻击,和一场7小时的失明。IDCF Cloud事件最值得我们记住的,不是黑客有多嚣张,而是那句被公开写在人家控制台上的”YOUR CLOUD IS OURS”。云平台的安全,从来不取决于你买了多少安全设备,而取决于当攻击者真正进来时,你的团队能不能在第一时间”看见”、能不能在数据被抹除前”保住备份”、能不能在混乱中”止损”。这三件事,任何一件掉链子,7小时后就只能对着屏幕发愣。别等勒索信堆满225个目录,才发现自己一直在重启一场早就结束的战争。

更多AI知识,请扫码关注Aiker World社区公众号

Aiker World社区网址:https://aikerworld.com

Aiker World(AI世界)-聚焦AI人才与智能体工具的垂直专家社区。专家领航+人才汇聚+工具赋能,打通AI技术与产业落地断层,为AI从业者、开发者及企业提供一站式成长与协作平台。

本文翻译自 原文链接。如若转载请注明出处。 商务合作,文章发布请联系 anquanke@360.cn

本文由安全客原创发布

转载,请参考转载声明,注明出处: https://www.anquanke.com/post/id/316231

安全KER - 有思想的安全新媒体

如若转载,请注明出处:

安全KER - 有思想的安全新媒体

微信
    []
+10赞安全客微信

发表评论

您还未登录,请先登录。

登录

前往「安全客」阅读原文 →
Radicle 披露了可能导致私有仓库以明文形式暴露的关键漏洞
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「InfoQ 中文」,版权与著作权归原作者/原站点所有。原文链接:https://www.infoq.cn/article/h86bNjSBdJRBYwxP4Xgt?utm_source=rss&utm_medium=article
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读去中心化代码托管平台Radicle披露关键漏洞,可能导致私有仓库内容以明文形式暴露。建议相关用户立即升级版本并排查历史访问日志,以防源码泄露。
[

点对点代码协作网络 Radicle 披露了其核心网络协议中存在的两个关键安全漏洞。这些漏洞会导致迄今为止所有节点版本的机密性不复存在。这些缺陷使得网络路径上的攻击者能够以明文形式读取私有仓库的数据,并冒充连接白名单中的节点。由于现有协议的设计缺乏版本协商功能,项目维护者无法部署向后兼容的网络层缓解措施,所以他们的建议是立即暂停明网私有仓库的运行,直至完成重大的架构改造。

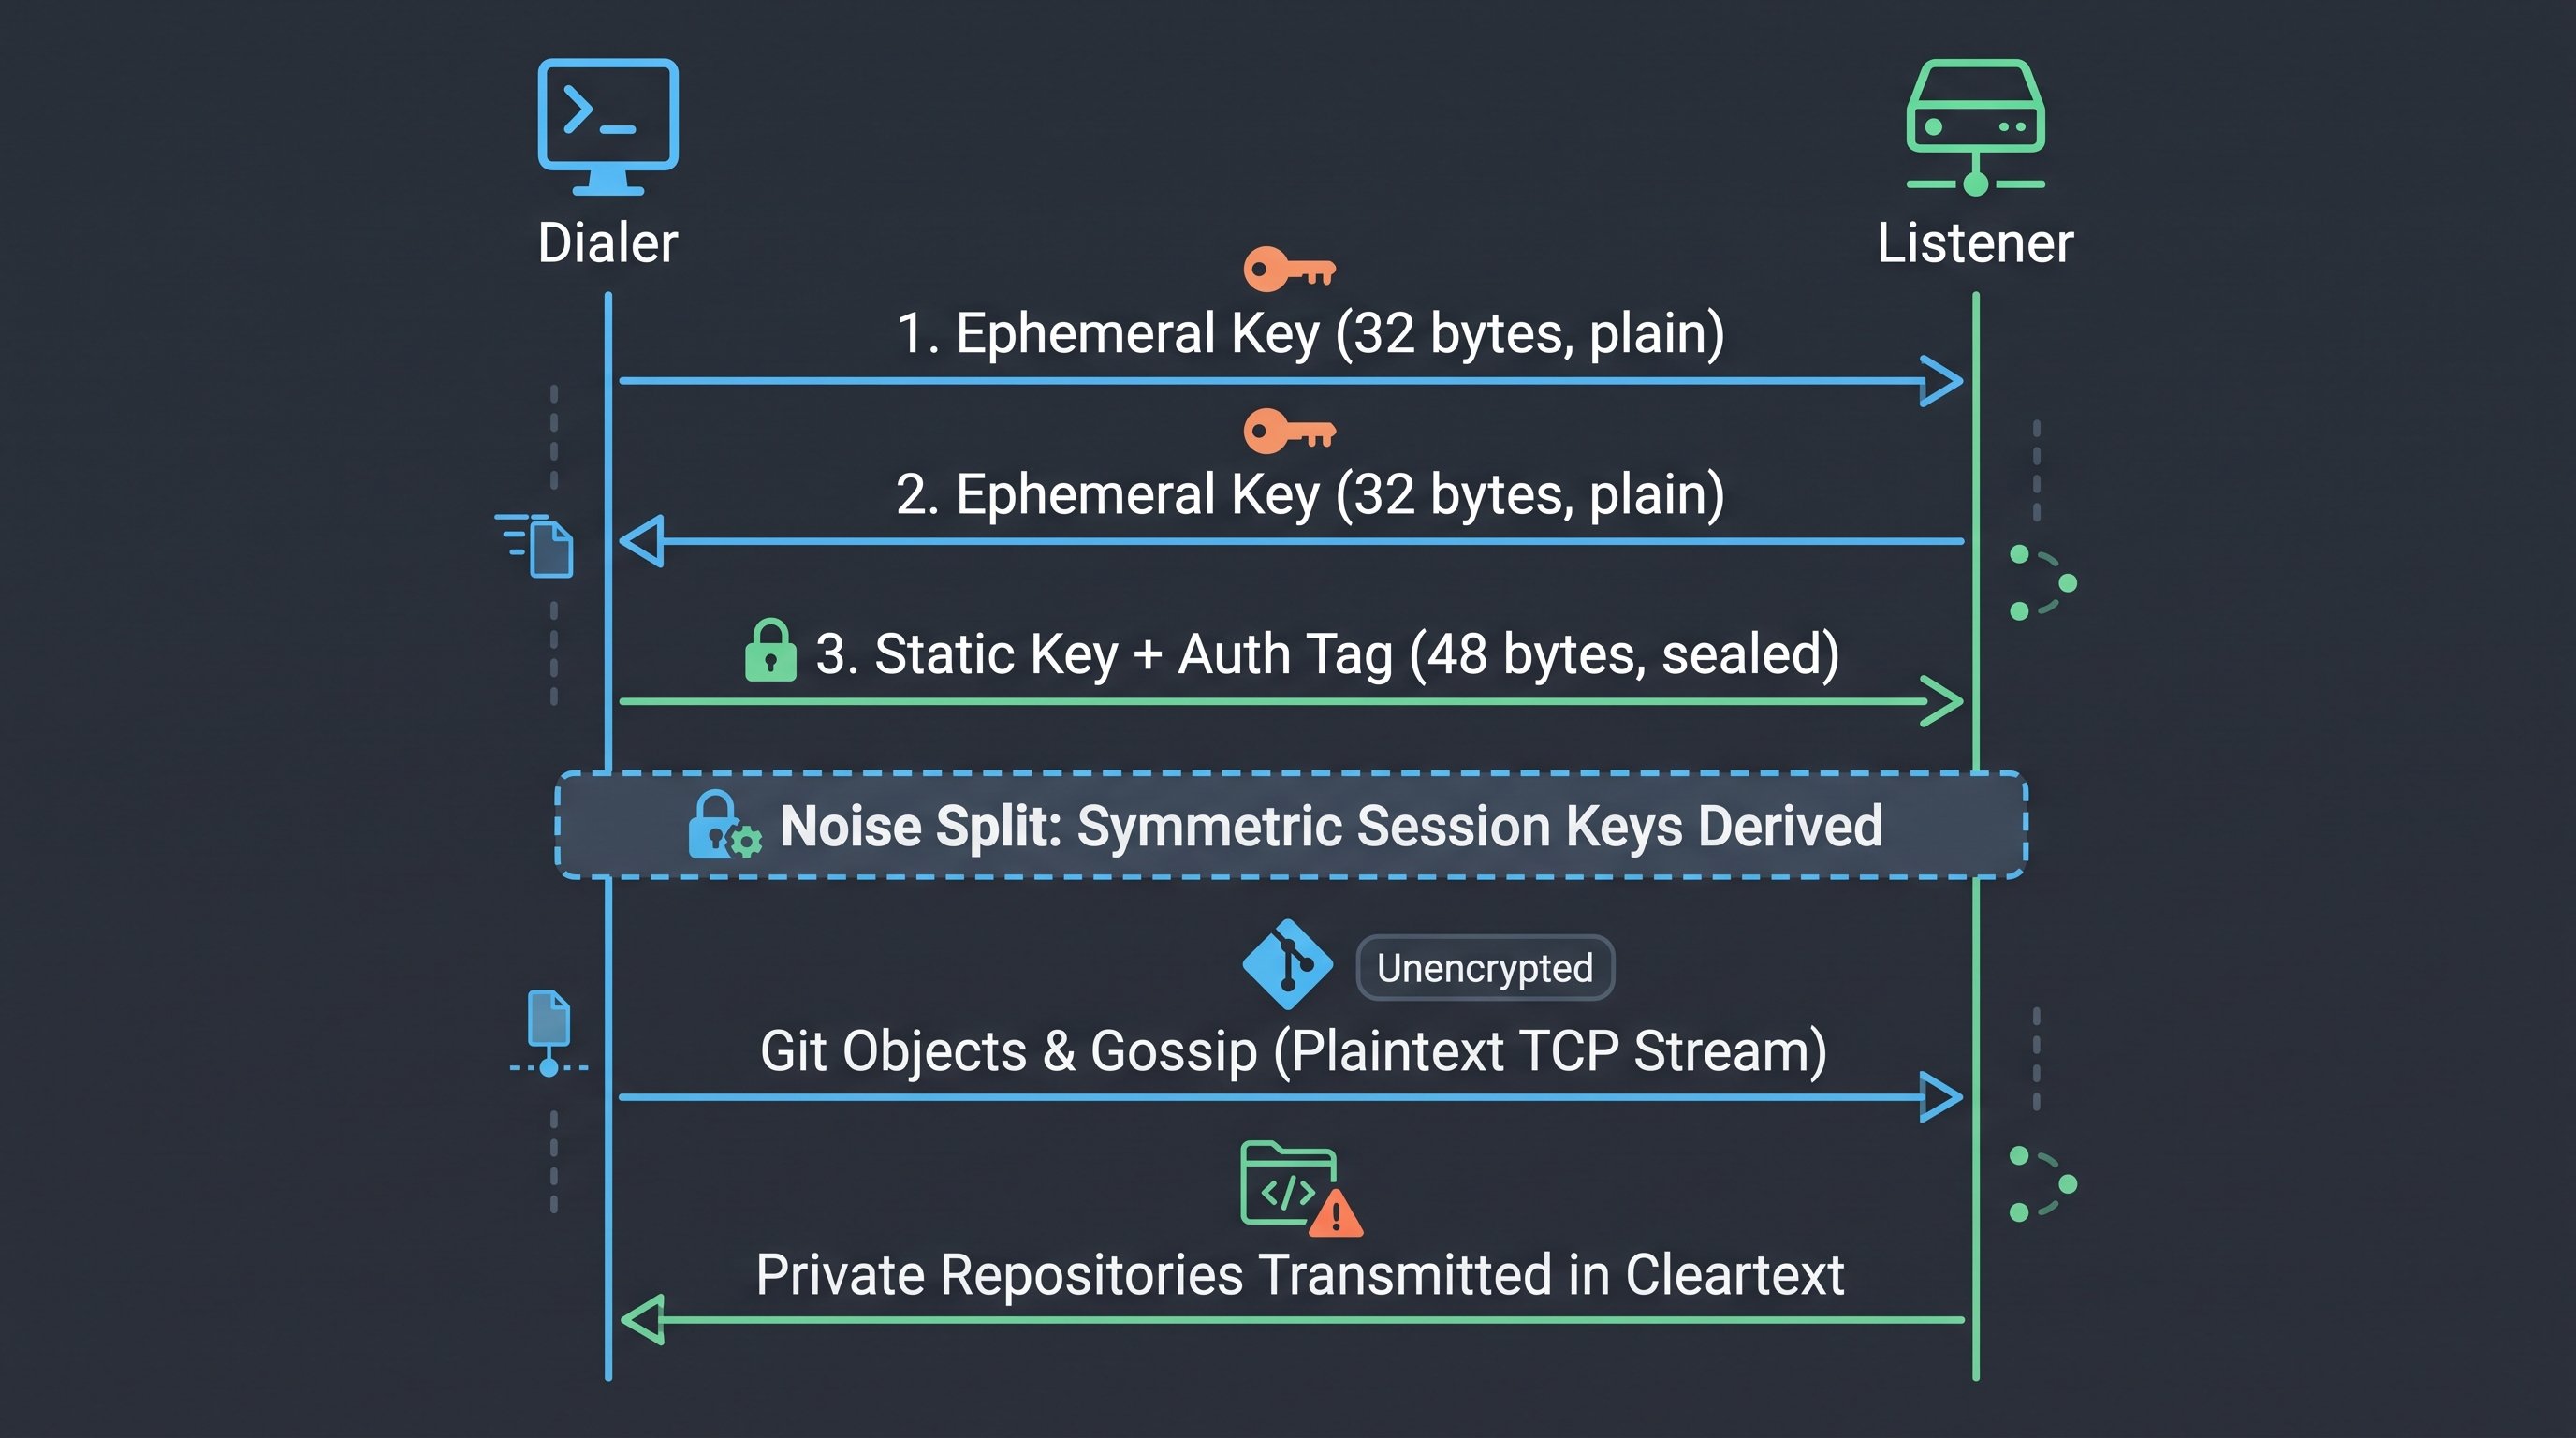
该漏洞披露报告指出了 radicle-node(负责管理对等节点同步的主要守护进程)内部存在的两个截然不同的协议层缺陷。独立工程师 Kostis Maninakis 发现,虽然 Radicle 在建立连接时会执行 Noise Protocol Framework 握手流程,但该守护进程会在协商完成后立即丢弃生成的加密状态。

Radicle 采用了基于原始 TCP 套接字的三消息 Noise XK 握手模式。发起方和响应方交换临时密钥和长期公钥,并以此推导出两个对称会话密钥。这一操作过程在密码学中被称为“拆分”(split)。然而,radicle-node 会将这些推导出的密钥以未加密的形式保存在内存中。此后的一切通信,包括 Gossip 元数据、路由表和原始 Git 对象包,均以明文的形式直接通过未加密的 TCP 套接字进行传输。

]
前往「InfoQ 中文」阅读原文 →
计算机底层2 条
SvelteKit 3 进入 RC:svelte.config.js 没了,$lib 也要退休
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「InfoQ 中文」,版权与著作权归原作者/原站点所有。原文链接:https://www.infoq.cn/article/Hs5X7EdO6PNHk367zZv3?utm_source=rss&utm_medium=article
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读SvelteKit 3进入RC阶段,移除svelte.config.js配置文件并弃用$lib别名。此次架构调整旨在简化构建流程,但要求现有项目进行配置迁移与路径重构。
[

Svelte 团队已推动 SvelteKit 3 进入候选发布阶段,并将此次更新定位为清理旧代码、为框架未来演进奠定基础的机会,而不是一次包含大量新功能的发布。如果测试顺利,预计随后将发布稳定版本,且不会再有破坏性变更。

最主要的变化是配置位置。SvelteKit 2 中的 svelte.config.js 已被移除,配置现在位于 vite.config.ts 中,使 Vite 插件能够同步读取配置,而不必等待异步解析步骤;此前,该步骤必须等到完整的 Vite 配置解析完成后才能开始。参考文档指出,通过 Vite 进行配置早在 2.62 版本中就已引入,因此此次候选版本是对已经开始的迁移过程作出最终确认。

争议最大的一项变化是移除 $lib 别名,改用 #lib。后者依赖在 package.json 中声明的 Node 原生子路径导入,而不是使用需要 Vite 和 TypeScript 协同处理的 SvelteKit 专用路径。开发者现在还需要添加文件扩展名,即把 $lib/foo 改为 #lib/foo.js。

迁移指南建议现有应用使用以下 CLI 命令:

npx sv@next migrate sveltekit-3 --tasks all --confirm
复制代码

在 Reddit 上,一位开发者写道,自己讨厌 lib 的这项变化:

我讨厌从 $lib 改成 #lib,这使它与 $app 等其他内容不再一致。希望不会强制要求使用 #lib,而是允许我们使用任何想用的别名。

另一位回复者起初表示赞同,随后承认这是“一项很棒的变化”:

是啊,这背后的逻辑是什么?

编辑:哦,算了,这是一项很棒的变化。他们正在将它迁移到 package.json 原生的别名定义中。这意味着,你可以在某些可能需要脱离 SvelteKit 运行的 lib/server 代码中使用该别名。

在最初的 GitHub Issue 中,维护者 Rich Harris 坦率地谈到了其中的权衡。他表示,自己“很希望所有人都使用 nodenext”,但无扩展名导入可能会让“用户反感”,并补充称,任何反对这一变化的人“始终可以创建自己的别名”。

tsconfig.json 现在继承 $app/tsconfig,而不是生成的 .svelte-kit 文件;Service Worker 从 $app/env、$app/paths 和新的 $app/manifest 模块中获取内容;显式环境变量也结束实验阶段,并可选择使用 Standard Schema 进行验证。由于 SvelteKit 3 要求使用 Svelte 5,错误处理也得到了改进:+error.svelte 组件会在加载失败和渲染失败时显示,所有错误都会流经 handleError,堆栈跟踪也会获得 Source Map。浅层路由从 pushState 迁移到 goto,并使用 shallow: true 选项。

在底层,SvelteKit 3 现在要求使用 Vite 8 及其 Rolldown 打包器,以实现更快的构建。不过,该团队拒绝采用 FetchableDevEnvironment,理由是它迫使框架承担过多复杂性。仍然隐藏在实验性标志之后的是远程函数,这是一种类型安全的客户端—服务器 RPC 方法,与 React Server Actions 和 Next.js 服务器函数相呼应。该团队表示,相比之下,它让 load 函数和 actions 显得“有些笨拙”。

SvelteKit 是 Svelte 的官方应用框架,构建于 Vite 之上,由目前已加入 Vercel 的 Svelte 团队维护。它负责处理路由、服务器端渲染、数据加载和部署适配器,使开发者能够使用基于编译器的 Svelte UI 框架构建全栈 Web 应用程序,而不必使用虚拟 DOM。自 2022 年末发布 1.0 版本以来,它已经成为构建 Svelte 应用的默认方式。它将自身定位为 Next.js 和 Remix 等 React 框架的竞争者,同时依托 Svelte 更小的运行时和响应式语法。

原文链接:https://www.infoq.com/news/2026/09/sveltekit-3-vite/

]
前往「InfoQ 中文」阅读原文 →
Meta ZGateway 在每秒处理超过 10 亿次操作的同时,将 ZippyDB 的连接数减少了 19 倍
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「InfoQ 中文」,版权与著作权归原作者/原站点所有。原文链接:https://www.infoq.cn/article/d5x9BkQ9AoIZq5mf6LN0?utm_source=rss&utm_medium=article
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读Meta开源ZGateway组件,在每秒处理超10亿次操作的同时,将底层ZippyDB的连接数减少19倍。该方案通过连接复用与路由优化,有效缓解高并发下数据库连接池耗尽问题。
[

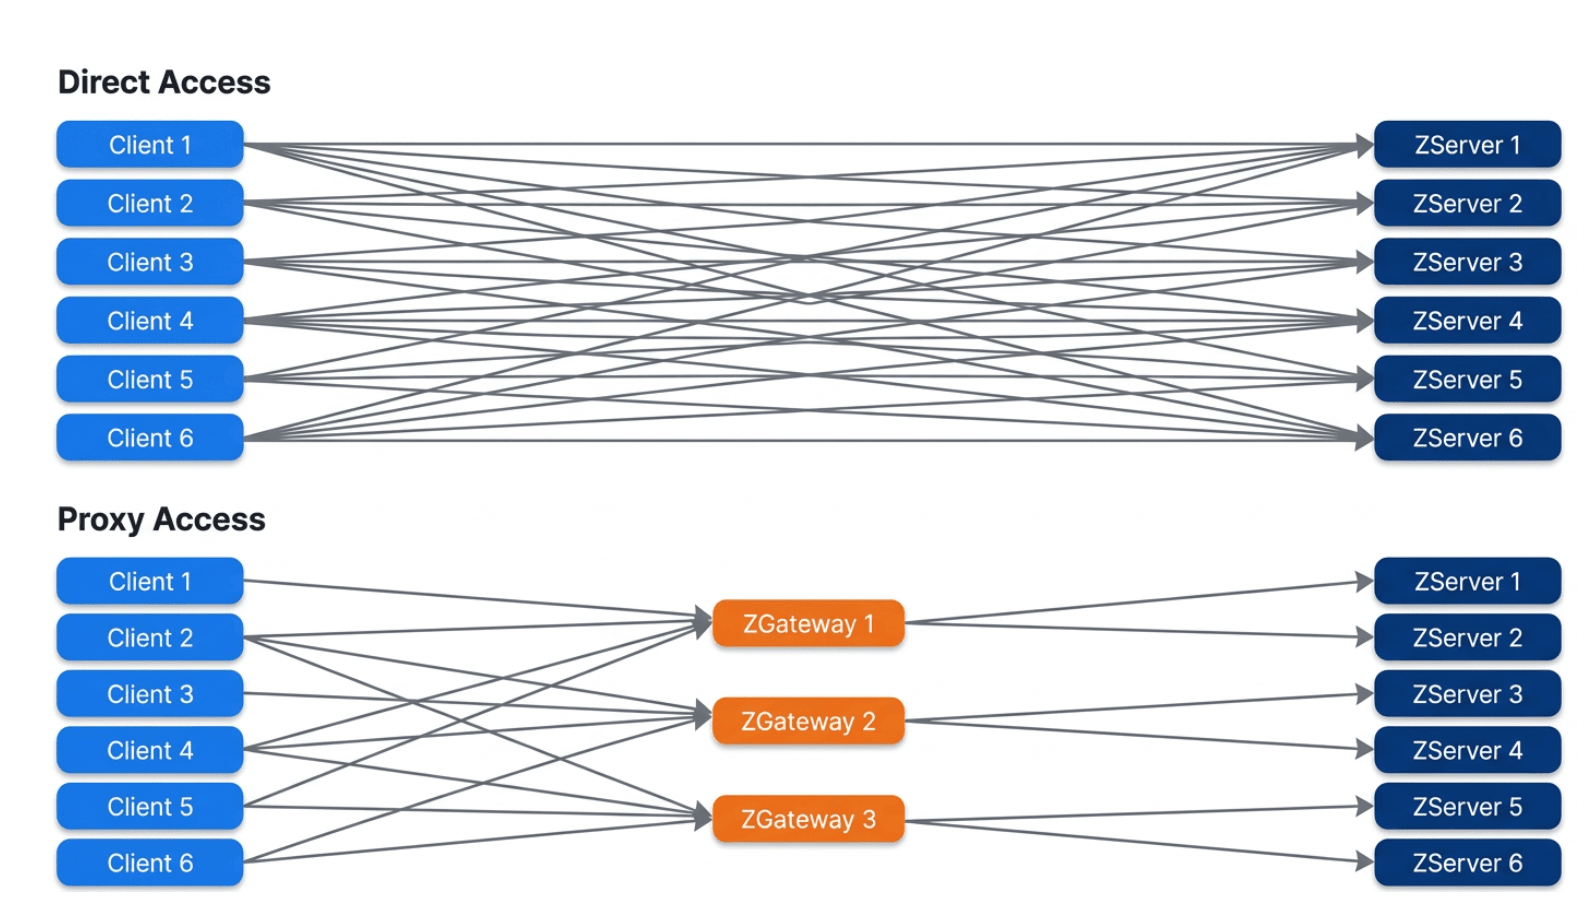
Meta 推出 ZGateway,这是一个面向其广泛使用的分布式键值存储系统 ZippyDB 的无状态代理层,旨在解决由超过 100 万个客户端主机带来的连接和可靠性挑战。该网关每秒处理超过 10 亿次操作,并承担了 ZippyDB 约 40% 的流量;而根据 Meta 的模型估算,该架构将持久连接总数减少为原来的约 1/19。

]
前往「InfoQ 中文」阅读原文 →
算力与硬件1 条
智谱新模型,490 tokens/s!
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「量子位」,版权与著作权归原作者/原站点所有。原文链接:https://www.qbitai.com/2026/10/502649.html
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读智谱发布新版GLM模型,推理速度达490 tokens/s。该指标显著提升大模型在高并发场景下的吞吐能力,为工程端降低延迟和算力成本提供新选项。
听雨10:37:04摘要样式

GLM「速度仙人」来了?

听雨 发自 凹非寺
量子位 | 公众号QbitAI

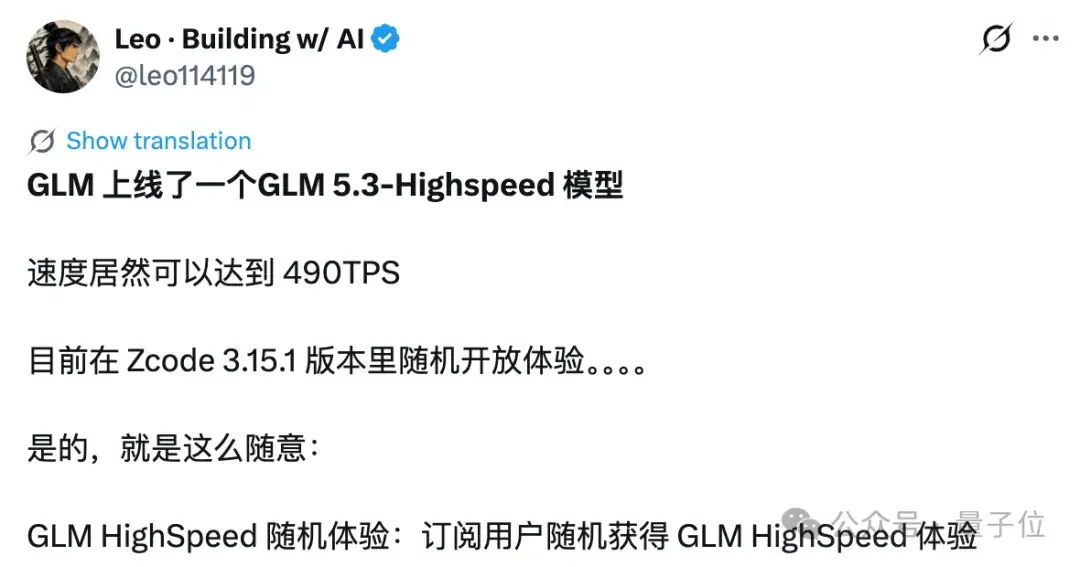
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。

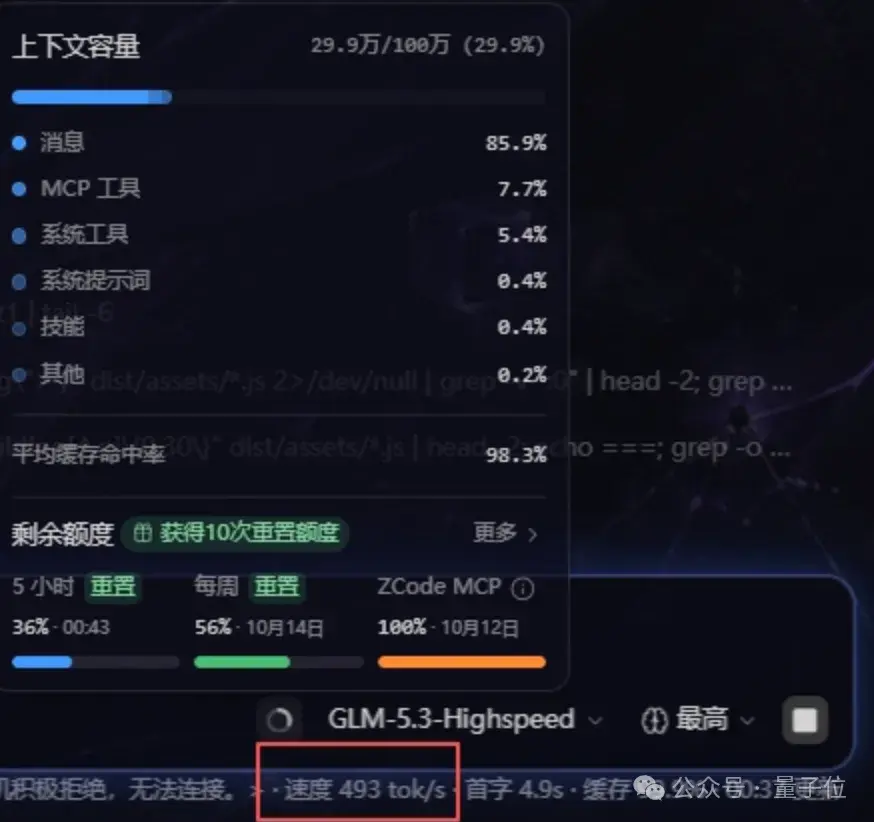
据网友@leo114119爆料,这个新模型目前已经在Zcode 3.15.1里开放体验,订阅用户随机获得。

他晒出来的速度,甚至达到了490 tokens/s。

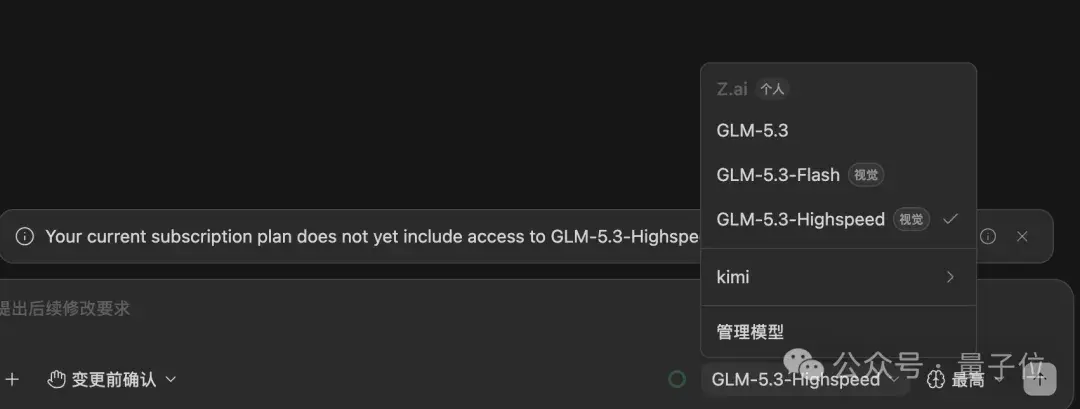
我也第一时间去Zcode里试了试,尝试手动添加并切换了这个模型。

但不知道是因为Lite套餐用户还不具备享受资格,还是因为没灰度到😭。。。

只能先望洋兴叹了(:з」∠)

GLM-5.3高速版来了?

既然是高速模型,那最值得关注的当然是速度了。

490TPS——这个网友晒出来的速度数字,也是相当恐怖了,接近500TPS。

TPS指的是每秒生成的token数量。如果持续保持这一速度,输出1万token,单算生成阶段约需20秒。

要知道,上个月智谱刚发布的GLM-5.3-FlashX,最高速度也才200 tokens/s。

而按照Artificial Analysis的测速,GLM-5.3-Flash在Z.ai API上的输出速度约为60 tokens/s。

这新模型是什么速度仙人啊???

而且GLM-5.3-Highspeed这个名字,此前已有迹象。

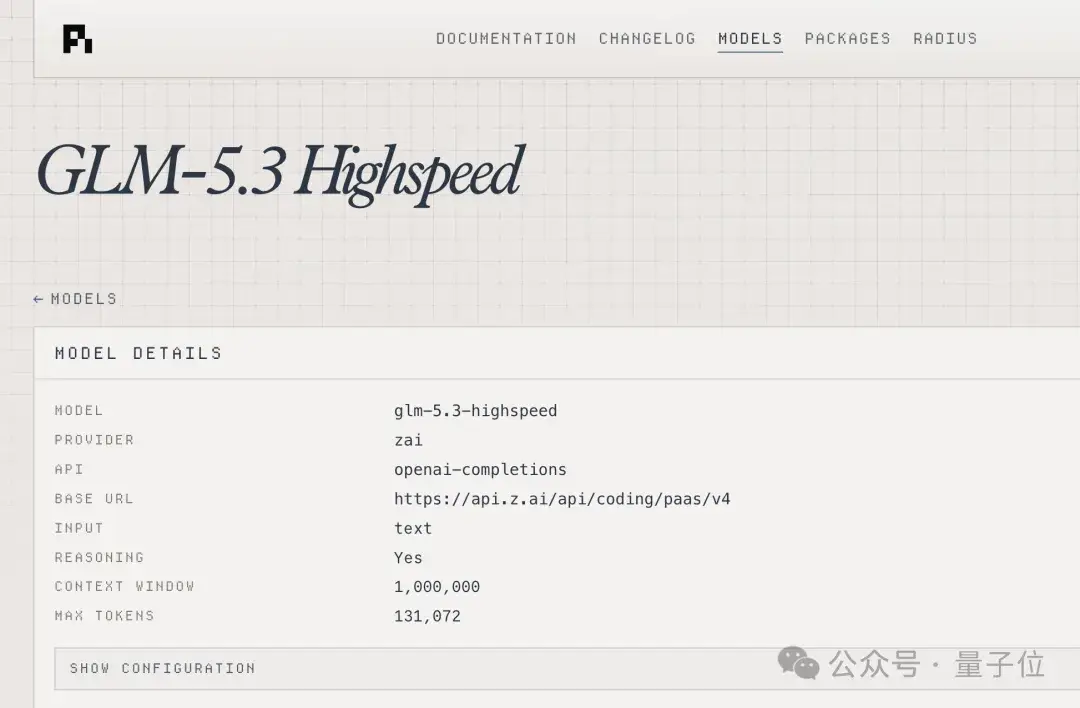
Pi的模型目录已经收录了GLM-5.3-Highspeed。

在这份目录中,GLM-5.3-Highspeed上下文窗口为100万token,最大生成token上限为131,072,约128k;还划分了low、high、max三档思考强度配置。

不过,这些配置与GLM-5.3普通版也都是一致的。

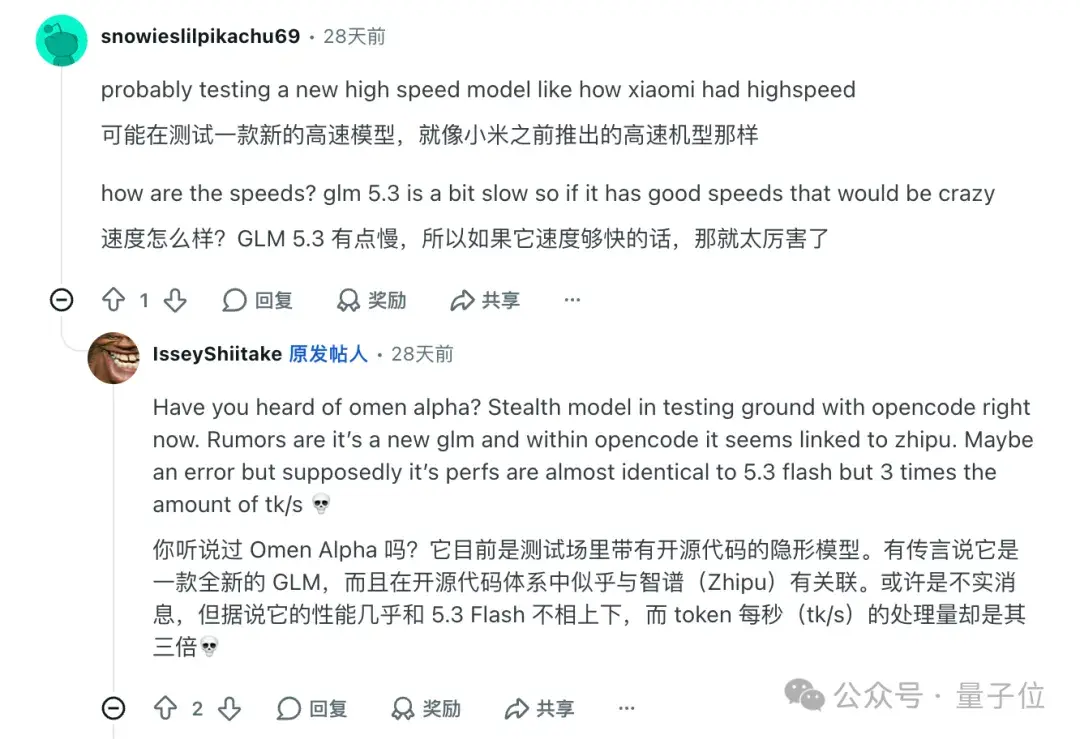
此外,也有网友在reddit上讨论过这款新模型,并猜测它是否与OpenCode上的匿名模型Omen Alpha有关。

Omen Alpha在9月份刚刚上新OpenCode,基本已经被网友扒出来与GLM有关。

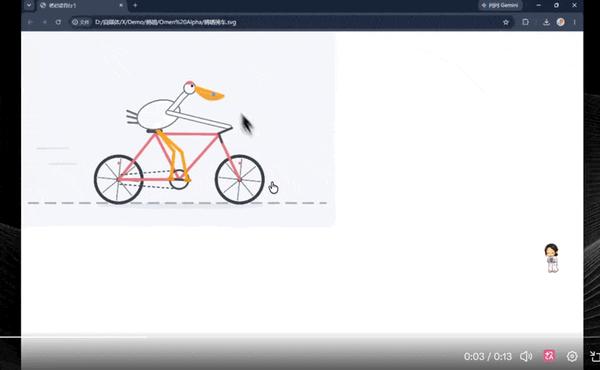
还有网友实测了下鹈鹕踩单车的水平。。

动图封面

总结来说就是:速度快,思考久,效果还蛮好。

至于Omen Alpha到底是什么模型,也是众说纷纭。

有人说它就是GLM-5.3-Highspeed,也有人猜GLM-5.3-Omni、GLM-5.4-Flash。

此前,智谱也推出过高速版模型。

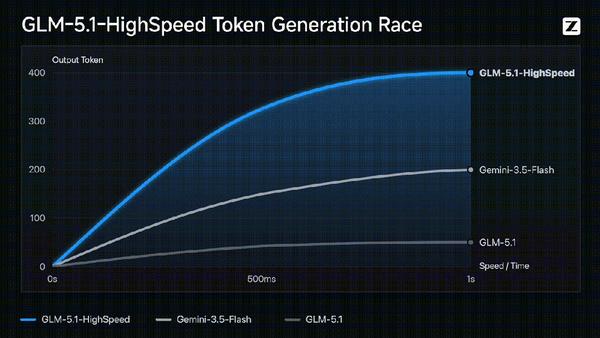
今年5月,智谱推出了GLM-5.1-highspeed,模型输出速度为400tokens/s,在当时基本也是刷新了全球大模型厂商API的速度上限。

动图封面

这回的GLM-5.3-Highspeed如果真能达到490 TPS的水平,那对于长程任务来说,速度也是相当可观的了。

目前这款新模型还在Zcode里随机灰度中,如果有灰度到的网友,欢迎分享你的实测体验呀!!

版权声明版权所有,未经授权不得以任何形式转载及使用,违者必究。
前往「量子位」阅读原文 →
一句话快讯2 条
Blood cells from 80-year-old donor become stem cells with molecular age under 20
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「Hacker News」,版权与著作权归原作者/原站点所有。原文链接:https://doi.org/10.1111/acel.70751
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读Hacker News热帖:研究显示80岁供体的血细胞经重编程为干细胞后,其分子年龄特征降至20岁以下水平。该成果发表于Aging Cell,为衰老逆转研究提供新数据。
本篇未能抓到原文正文(对方站点改版或有访问限制),请点击下方按钮前往原文阅读。
前往「Hacker News」阅读原文 →
科技云报到:AI Agent 的“量产关”:89% 的试点倒在生产门口,谁在补位?
⚠ 非原创 · 转载 本文为转载内容,原文刊载于「安全客」,版权与著作权归原作者/原站点所有。原文链接:https://www.anquanke.com/post/id/316218
如相关内容涉及侵权,请联系 874319327@qq.com 删除。
破晓导读行业数据显示89%的AI Agent试点项目未能进入生产环境。瓶颈集中在可靠性验证、成本控制与企业系统对接,提示工程团队需优先解决落地链路而非单纯追求模型能力。

阅读量28833

x
译文声明

本文是翻译文章

译文仅供参考,具体内容表达以及含义原文为准。

科技云报到原创。

AI Agent 的竞争重心,正在从“能不能造出来”转向“能不能跑起来”。

10月9日凌晨,谷歌云在 Gemini at Work 大会上正式推出企业通用智能体 Gemini Agent,试图让一个智能体自主拆解任务、调用企业数据、编写代码、生成文档,甚至以拥有独立企业身份的数字同事参与团队协作。

与此同时,行业讨论中一个越来越清晰的共识是:当AI Agent 从演示视频走进客服、研发、供应链和办公系统,企业真正担心的不是它能不能回答问题,而是它会不会断线、会不会串数据、出了故障谁来查、安全合规能不能过?

这个问题的紧迫性,有数据支撑。

Gartner 预测,到2027年底,40% 的 Agentic AI 项目将因成本攀升、业务价值不清晰或风险控制不足而被取消。

Gartner 杰出副总裁分析师 Erick Brethenoux 的评论一语中的:“挑战不在于创造更强大的 AI Agent,而在于创造足够可靠、能够在明确问责与治理边界内运行的 Agent。”

事实上,这一判断并非突然出现。

过去几个月,从硅谷到中国,行业讨论的焦点一直在向同一个方向收敛:Agent 的瓶颈不在模型能力,而在生产环境里的可靠性、安全性与可运维性。

也正是在这个节点上,9月29日,亚马逊云科技宣布 Amazon Bedrock AgentCore 在由光环新网运营的中国(北京)区域和西云数据运营的中国(宁夏)区域正式可用,上线 Runtime、Gateway、Identity、Browser Tools、Code Interpreter、Observability 六项能力。

这六项能力并非孤立的功能堆叠,而是分别对应着Agent 从 PoC 走向生产时最常卡住的几个环节:

Runtime 解决长会话运行与弹性扩展,Identity 和 Gateway 解决身份凭据与访问合规,Observability 解决运行黑盒,Browser Tools 和 Code Interpreter 则拓展 Agent 与外部世界交互的边界。

换句话说,它们合在一起,构成了一套“生产级底座”的完整拼图。

Agent 的“量产关”

Agent“上线难”是第三方研究反复验证的结构性问题。

Deloitte 2026技术趋势研究显示,89%的企业 AI Agent 试点从未进入生产;Teradata 调查显示,78%的企业已有 Agent 试点,仅14%规模化至组织级使用;Gartner 2026年 CIO 调查显示,仅17%的组织实际部署 AI Agent,超60%预期两年内部署,Agentic AI 正处于技术成熟度曲线的“期望膨胀峰值”。

一是运维与扩展成本,复杂任务需长时间运行,短会话易断连,自建集群要自扛扩缩容与多租户负担;二是治理与框架绑定,多团队、多框架、多模型导致Agent 资产难统一治理,上层应用被底层模型锁死;三是安全与合规,容器级隔离难阻断会话间数据交叉污染,凭据托管与授权缺失;四是运行黑盒,推理与工具调用轨迹不可见。

分析机构观察到了“开发快”与“运维稳”之间的割裂。

Moor Insights & Strategy 指出,开发者或许能更快构建 Agent,但运维团队难以及时提供安全与扩展保障,反而拖慢上市。国内权威报告则从另一个角度指向了同一根源:不是开发能力不够,而是底座能力不足。

中国信通院《企业级智能体技术与应用研究报告(2026年)》明确指出:“企业级智能体的规模化应用,需要以稳定可靠的技术底座为支撑”,并提出需形成覆盖模型适配、记忆增强、工具调用、自主规划、多智能体协同等环节的综合能力体系。

框架解决“能不能造”

底座解决“能不能跑”

Amazon Bedrock AgentCore 的答案不是又一套开发框架,而是一层专为 Agent 打造的企业级全托管运营底座,贯穿构建、部署、运维全生命周期,把自建基础设施的“重活”接了过去。

弹性与成本侧,Serverless 架构可随流量从零到数十万并发会话即时扩缩容;针对长时间运行任务提供8小时运行时支持,仅按实际消耗的算力秒级计费。

安全侧,Identity 身份与凭据托管加 Gateway 安全网关保障进出安全与策略合规,Runtime 基于 microVM 硬件级虚拟化隔离,为每个会话提供独立计算环境。可见性侧,Observability 提供全链路追踪,Agent 每步决策可查可调。

更关键的是开放解耦:支持任意模型、任意开源Agent 框架与 MCP 标准协议,不把应用锁死在模型上。

Moor Insights & Strategy 认为,Amazon Bedrock AgentCore 以全面的 Agentic 平台填补了开发框架与生产运营之间的空白,设计理念是“扩展而非取代”现有框架,AWS 提供了市场上“最广泛、最全面”的路径。

技术社区则提供了冷静视角:有开发者文章指出,平台消除的是“无差别的重活”,不是“思考本身”——评估、护栏与成本预算仍需企业自己掌握。

托管底座解决“上线难”,不解决“Agent 好不好用”。

数字验证产线落地

研究机构Signal65(Moor Insights & Strategy 合作机构)的独立测评显示,相比传统自定义部署,使用Amazon Bedrock AgentCore 可将端到端开发速度提升2.1倍、云端部署速度提升5.2倍,减少75%的基础设施配置与集成接入时间,将 PoC 到生产交付时间缩短50%。

生产实践中,据亚马逊云科技发布:Cox Automotive 在不到一年内将17个企业级 Agent 推向生产,FleetMate 平台把车辆维修评估从8至48小时缩至30分钟。

汤森路透的平台工程枢纽首期实现70%自动化率与15倍生产力提升;爱立信在数百万行代码的复杂环境中规模化部署 Agent,研发效率两位数提升;Druva 将安全事故调查从30至60天缩至数分钟,68%的客户问题由 Agent 工作流解决。

落地中国区: 底座之争才刚开始

对中国区客户,本地区域可用的直接价值是就近构建运行Agent、更低延迟与更高效服务。

能力之外,AgentCore 瞄准国内企业聚焦的场景:内容生产端到端自动化链路、数字员工与办公提效、智能客服7×24小时多轮交互、智能家居与汽车售后等垂直改造。

目前,亚马逊云科技正与汽车、医疗健康、软件服务、零售消费等领域的中国本土先锋合作,推进定制化落地方案。

值得留意的是,Gartner 预测到2028年,70%的企业将放弃由厂商“前置部署工程”模式构建的 Agentic AI,原因在于成本飙升且无法自主演进。

这一判断反向印证了开放、解耦、可自主演进底座的价值。Agent 竞争已进入新阶段:不比谁造得出 Demo,而比谁先跑通生产、养得起规模。Amazon Bedrock AgentCore 中国区正式可用,是 AWS 在新战场的明确押注。

对企业而言,选择底座不只是选功能,更是选择能否随模型与业务一起演进。

【关于科技云报到】

企业级IT领域Top10新媒体。聚焦云计算、人工智能、大模型、网络安全、大数据、区块链等企业级科技与数字化转型与赋能的领域。原创文章和视频获工信部权威认可,是世界人工智能大会、数博会、国家网安周、可信云大会与全球云计算等大型活动的官方指定传播媒体之一。

本文翻译自 原文链接。如若转载请注明出处。 商务合作,文章发布请联系 anquanke@360.cn

本文由科技云报到原创发布

转载,请参考转载声明,注明出处: https://www.anquanke.com/post/id/316218

安全KER - 有思想的安全新媒体

如若转载,请注明出处:

安全KER - 有思想的安全新媒体

微信+10赞科技云报到微信

发表评论

您还未登录,请先登录。

登录

前往「安全客」阅读原文 →
今日锐评 · 指标繁荣掩盖不了落地困境,工程界需回归系统级思考。
破晓前哨 · 每日技术前沿速览
本页内容为转载聚合,非原创;每条情报均已在正文开头标注来源站点与原文链接,版权归原作者所有。
如涉及侵权,请联系 874319327@qq.com 第一时间删除。
京ICP备2023030395号-1